Chaînes de tâches et opérations
À jour au 2026-10-04
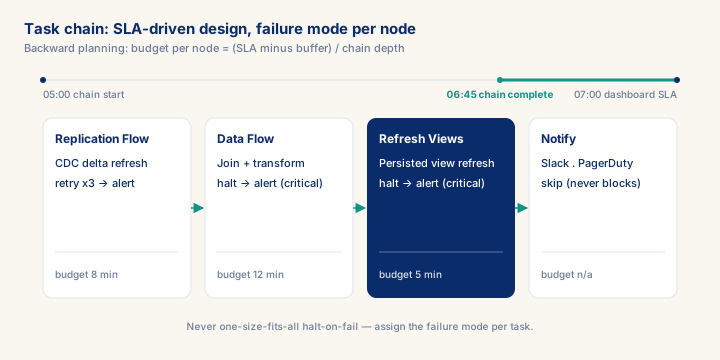
Task chains = orchestration DAG. Pattern senior : concevoir avec la data layout semaine 1, modes d'échec par tâche (retry/skip/halt), budget runtime SLA-driven par nœud, télémétrie vers BTP Audit Log + monitoring. Travailler en marche arrière depuis SLA dashboard vers ingestion. Tâches qui dépassent le budget = cible de redesign.
Ce que vous apprendrez
- Travailler un scénario réaliste : Clôture financière quotidienne DAX-40, SLA dashboard à 7h, 12 sources, 3 transformations, 3 modèles analytiques.
- Repérer et éviter l'anti-pattern : Arrêt sur échec uniforme pour tout — Une tâche de notification en échec stoppe toute la chaîne.
- Appliquer la décision clé du module : Mode d'échec par tâche — choisir Réessai+backoff transitoire · sauter+alerter non-critique · arrêter+alerter critique, pas Un arrêt-sur-échec unique pour tout.
- Mesurer la maîtrise avec le KPI : Taux de respect du SLA (cible : > 99 % des exécutions terminées à temps ; signal d'alerte : < 95 % = pattern de dépassement de budget).
Aperçu du module
Les task chains = la couche d'orchestration dans Datasphere. Sans task chains, chaque Replication Flow + Data Flow tourne sur son propre planning, les dépendances sont du savoir tribal, et le rafraîchissement dashboard 6h échoue silencieusement quand un feed source est en retard. Les consultants senior conçoivent la chain en même temps que la data layout en semaine 1.
Une task chain = graphe orienté acyclique (DAG) de :
- Runs Replication Flow (CDC delta).
- Runs Data Flow (transformations).
- Refresh de vues persistées.
- Callouts HTTP (notif Slack, trigger pipeline downstream).
- Branches conditionnelles (succès / échec).
Signal craft senior — gestion d'échec. Un junior écrit une chain qui s'arrête au premier échec. Un senior conçoit des modes d'échec par tâche : retry avec backoff pour erreurs transitoires, alert + skip pour non-critique, alert + halt pour critique, notification conditionnelle par sévérité. La chain est auditable et survit aux appels ops à 3h du matin.
Prérequis
- Revoir d'abord les concepts fondamentaux : C007, C008, C041
Acquis
- Travailler un scénario réaliste : Clôture financière quotidienne DAX-40, SLA dashboard à 7h, 12 sources, 3 transformations, 3 modèles analytiques.
- Repérer et éviter l'anti-pattern : Arrêt sur échec uniforme pour tout — Une tâche de notification en échec stoppe toute la chaîne.
- Appliquer la décision clé du module : Mode d'échec par tâche — choisir Réessai+backoff transitoire · sauter+alerter non-critique · arrêter+alerter critique, pas Un arrêt-sur-échec unique pour tout.
- Mesurer la maîtrise avec le KPI : Taux de respect du SLA (cible : > 99 % des exécutions terminées à temps ; signal d'alerte : < 95 % = pattern de dépassement de budget).
Module complet réservé aux abonnés. Le module complet ajoute : le cadre de décision · le cas guidé de bout en bout · la grille de KPI · les anti-patterns · les blocs de code · le contrôle de connaissances · les schémas.