LLM sur données d'entreprise : generative AI hub, BDC et SAP Databricks
À jour au 2026-10-10
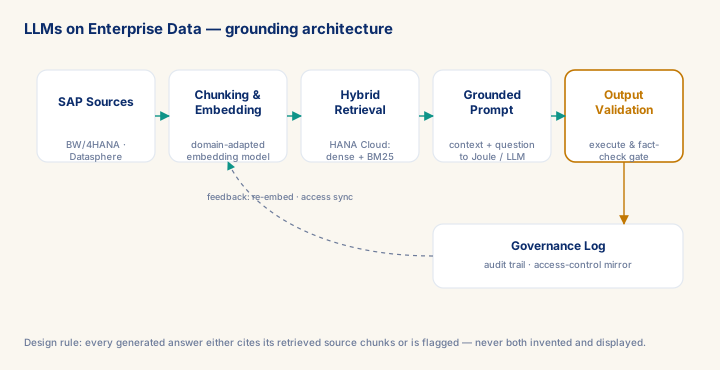
Les LLM sur données SAP sont un problème d'architecture, pas un choix de modèle. SAP livre quatre voies : le generative AI hub de SAP AI Core (plan extended ; bibliothèque de modèles et service d'orchestration enchaînant modèle de prompt, ancrage, masquage, filtrage de contenu, traduction et sortie structurée) ; SAP Business Data Cloud avec SAP HANA Cloud (moteurs vectoriel et de graphe de connaissances, « la base de données IA » de BDC) et SAP Databricks (produits de données partagés sans copie via Delta Sharing) ; Joule et les agents Joule Studio pour les utilisateurs finaux ; enfin des modèles natifs pour les tables (SAP-RPT-1.6, TabPFN-3.5 Plus) pour les prédictions qu'un LLM ne doit pas faire. La qualité de production vient des métadonnées sémantiques, des appels d'outils pour les valeurs exactes, des citations, du bac à sable SQL, du masquage et d'un jeu de référence porté par le métier.
Ce que vous apprendrez
- Affecter six cas d'usage IA réels à la bonne voie SAP (generative AI hub, BDC avec SAP HANA Cloud ou SAP Databricks, Joule/Joule Studio, SAP-RPT ou TabPFN) avec une justification écrite de cinq lignes pour chacun.
- Construire une configuration d'orchestration du generative AI hub combinant modèle de prompt, ancrage documentaire, masquage SAP Data Privacy Integration et filtrage de contenu, et prouver le masquage sur un prompt de test.
- Choisir le chemin des données par question — appel d'outil, ancrage documentaire, récupération HANA Cloud ou traitement par lots SAP Databricks — et expliquer la conséquence de chacun sur les autorisations.
- Mettre en place les contrôles de sortie pour la conversion langage naturel vers SQL (bac à sable, liste blanche d'objets, contrôle du résultat) et pour les textes générés (vérification nombre par nombre).
- Définir un jeu de référence porté par le métier et la règle de non-régression qui le rejoue à chaque changement de modèle, de prompt, de récupération ou de données.
Aperçu du module
Placer un grand modèle de langage (LLM) au-dessus des données SAP n'est pas un exercice de choix de modèle. Tout déploiement sérieux doit répondre aux quatre mêmes questions : où le modèle s'exécute-t-il et sous quel contrat, comment reçoit-il le bon contexte métier au bon moment, qu'est-ce qui l'empêche de divulguer ou d'inventer des données, et qui contrôle la sortie avant qu'une décision ne soit prise. SAP livre désormais une réponse concrète à chacune, répartie entre le generative AI hub de SAP AI Core, SAP Business Data Cloud (BDC) avec SAP HANA Cloud et SAP Databricks, et Joule. Ce module cartographie ces voies, montre comment construire sur chacune et enseigne les contrôles qui transforment une démonstration en système de production.
Prérequis
- Expérience pratique de SAP BTP et de SAP Datasphere ou SAP Business Data Cloud
- Revoir d'abord les concepts clés : C027, C203, C087
- Recommandé : module M053 (SAP AI Core & AI Launchpad)
Acquis
- Expliquer à un sponsor pourquoi le chemin des données, les contrôles et l'évaluation passent avant le choix du modèle.
- Exploiter le generative AI hub et ses modules d'orchestration via SAP AI Launchpad ou le SAP Cloud SDK for AI.
- Positionner SAP Databricks, SAP HANA Cloud et le generative AI hub comme les pièces complémentaires d'une même architecture.
- Orienter la prédiction tabulaire vers SAP-RPT ou TabPFN et n'utiliser le LLM que pour l'explication.
- Remettre un modèle d'évaluation et d'exploitation signé par le DPO et le responsable métier.
Module complet réservé aux abonnés. Le module complet ajoute : le cadre de décision · le cas guidé de bout en bout · la grille de KPI · les anti-patterns · les blocs de code · le contrôle de connaissances · les schémas.