Évaluation des modèles IA
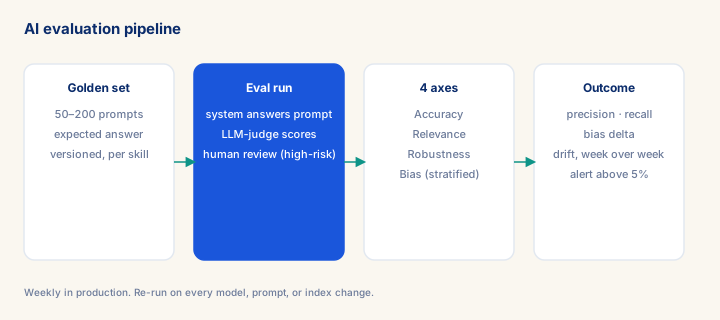
À jour au 2026-10-04
Évaluer quatre dimensions — exactitude/fidélité, pertinence, robustesse/sûreté, forme — par strate, jamais en un score unique. S'appuyer sur les outils que SAP livre dans le generative AI hub : les Evaluations (scénario genai-evaluations, exécutable simplifié genai-evaluations-simplified) avec des métriques calculées (BERT Score, BLEU, ROUGE, Exact Match, JSON Schema Match, Language Match, booléens de filtrage) et des métriques LLM-as-a-judge (Correctness, Answer Relevance, Instruction Following, Conciseness, RAG Groundedness, RAG Context Relevance) ; des métriques de juge personnalisées à grille explicite ; la Prompt Optimization ; et l'Inference Observability pour échantillonner le trafic de production. Les jeux de test sont des affirmations datées revalidées par les propriétaires des données ; les juges sont des instruments à étalonner. Aucune taille ni aucun seuil inventés.
Ce que vous apprendrez
- Concevoir un jeu de test stratifié et daté (cas nominal, limites, contrôle d'accès, malveillant/hors périmètre) avec cinq champs par entrée et un propriétaire de données nommé pour la revalidation
- Lancer une évaluation SAP AI Core (scénario genai-evaluations, exécutable genai-evaluations-simplified) comparant prompts et modèles avec les bonnes métriques prédéfinies — en sachant lesquelles exigent une réponse de référence
- Définir une métrique LLM-as-a-judge personnalisée avec une grille explicite et des exemples, et étalonner tout juge contre une relecture humaine et des réponses fausses plantées
- Séparer l'évaluation de la recherche (API Retrieval, RAG Context Relevance) de celle de la génération (RAG Groundedness, Correctness) pour les assistants ancrés
- Instrumenter la production avec l'Inference Observability (persistance metadata ou full, labels, retours) et remettre un runbook d'évaluation répété
Aperçu du module
L'évaluation est ce qui sépare « nous avons livré de l'IA » de « nous avons livré une IA qui fonctionne — et nous pouvons le prouver ». Un prompt, un assistant ancré ou un agent sans évaluation documentée et reproductible est un risque que personne ne sait mesurer, une qualité que personne ne sait défendre et une régression que le client découvrira par ses utilisateurs. Ce module enseigne la discipline et l'ancre sur les outils que SAP livre réellement dans le generative AI hub de SAP AI Core : les Evaluations, les métriques prédéfinies et personnalisées, la Prompt Optimization et l'Inference Observability. La méthode est transposable ; les outils permettent de l'appliquer dans le paysage SAP du client, avec des preuves que le client conserve.
Prérequis
- Avoir suivi ou lu le module pratique M325 (orchestration, prompt registry)
- Revoir d'abord les concepts fondamentaux : C204, C118, C027
Acquis
- Construire et versionner un jeu de test stratifié qui résiste aux évolutions des données parce que chaque entrée est datée et a un propriétaire.
- Choisir correctement les métriques prédéfinies SAP et ajouter des métriques de juge personnalisées qui encodent les règles métier.
- Diagnostiquer une réponse ancrée fausse comme un problème de recherche ou de génération avant de modifier quoi que ce soit.
- Remettre un runbook répété et un échantillonnage de production via l'Inference Observability.
Module complet réservé aux abonnés. Le module complet ajoute : le cadre de décision · le cas guidé de bout en bout · la grille de KPI · les anti-patterns · les blocs de code · le contrôle de connaissances · les schémas.