KI-Modellevaluierung
Stand
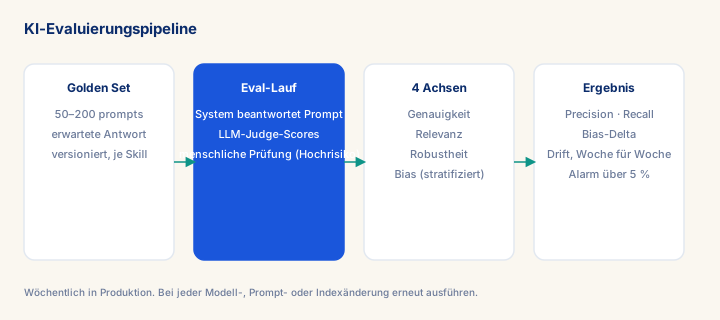
Vier Dinge evaluieren — Korrektheit/Faithfulness, Relevanz, Robustheit/Sicherheit, Form — je Schicht, nie als ein einziger Wert. Umsetzung mit den Werkzeugen, die SAP im Generative AI Hub ausliefert: Evaluations (Szenario genai-evaluations, vereinfachtes Executable genai-evaluations-simplified) mit berechneten Metriken (BERT Score, BLEU, ROUGE, Exact Match, JSON Schema Match, Language Match, Filter-Booleans) und LLM-as-a-Judge-Metriken (Correctness, Answer Relevance, Instruction Following, Conciseness, RAG Groundedness, RAG Context Relevance); eigene Judge-Metriken mit expliziten Rastern; Prompt Optimization; und Inference Observability für Stichproben aus der Produktion. Testsets sind datierte Aussagen, die Dateneigentümer revalidieren; Judges sind Instrumente, die kalibriert werden müssen. Keine erfundenen Größen oder Schwellen.
Was Sie lernen
- Ein geschichtetes, datiertes Testset entwerfen (Normalfall, Grenzfälle, Zugriffskontrolle, böswillig/themenfremd) mit fünf Feldern je Eintrag und einem benannten Dateneigentümer für die Revalidierung
- Eine SAP-AI-Core-Evaluierung ausführen (Szenario genai-evaluations, Executable genai-evaluations-simplified), die Prompts und Modelle mit den passenden systemdefinierten Metriken vergleicht — im Wissen, welche eine Referenzantwort brauchen
- Eine eigene LLM-as-a-Judge-Metrik mit explizitem Raster und Beispielen definieren und jeden Judge gegen menschliche Prüfung und platzierte Falschantworten kalibrieren
- Bei gegroundeten Assistenten die Evaluierung des Retrievals (Retrieval-API, RAG Context Relevance) von der der Generierung (RAG Groundedness, Correctness) trennen
- Die Produktion mit Inference Observability instrumentieren (Persistenz metadata oder full, Labels, Feedback) und ein geprobtes Evaluierungs-Runbook übergeben
Modulüberblick
Evaluierung trennt „wir haben KI ausgeliefert“ von „wir haben KI ausgeliefert, die funktioniert — und können es belegen“. Ein Prompt, ein gegroundeter Assistent oder ein Agent ohne dokumentierte, wiederholbare Evaluierung ist ein Risiko, das niemand beziffern kann, eine Qualität, die niemand verteidigen kann, und eine Regression, die der Kunde über seine Nutzer entdeckt. Dieses Modul vermittelt die Disziplin und verankert sie in den Werkzeugen, die SAP im Generative AI Hub von SAP AI Core tatsächlich ausliefert: Evaluations, systemdefinierte und eigene Metriken, Prompt Optimization und Inference Observability. Die Methode ist übertragbar; die Werkzeuge erlauben es, sie in der SAP-Landschaft des Kunden anzuwenden — mit Nachweisen, die beim Kunden bleiben.
Voraussetzungen
- Das Praxismodul M325 (Orchestrierung, Prompt Registry) absolviert oder gelesen haben
- Zuerst die Kernkonzepte wiederholen: C204, C118, C027
Lernergebnisse
- Ein geschichtetes Testset aufbauen und versionieren, das Datenänderungen übersteht, weil jeder Eintrag datiert ist und einen Eigentümer hat.
- Die systemdefinierten SAP-Metriken richtig wählen und eigene Judge-Metriken ergänzen, die Fachregeln abbilden.
- Eine falsche gegroundete Antwort als Retrieval- oder Generierungsproblem diagnostizieren, bevor irgendetwas geändert wird.
- Ein geprobtes Runbook samt Produktionsstichproben über Inference Observability übergeben.
Vollständiges Modul für Mitglieder. Das vollständige Modul ergänzt: den Entscheidungsrahmen · das durchgehende Szenario · die KPI-Scorecard · die Anti-Muster · die Codeblöcke · die Wissenskontrolle · die Schemata.
Offene SAP-Projekte
Aktuelle SAP-Analytics-Projekte und Stellen im DACH-Raum: SAP-Analytics-Projekte im DACH-Raum.