Python dans les pipelines SAP
À jour au 2026-10-10
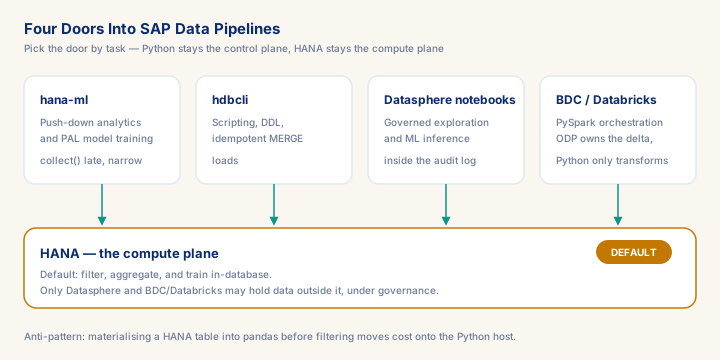
Python entre dans les pipelines SAP par quatre portes distinctes — l'analytique push-down hana-ml, le scripting hdbcli, les notebooks connectés via l'Open SQL Schema de Datasphere et l'orchestration BDC/Databricks — et la première décision d'une mission est de choisir la bonne porte, pas d'écrire le code. Se tromper coûte soit l'avantage push-down de HANA (des millions de lignes tirées dans pandas alors que HANA les aurait agrégées sur place), soit un doublon de la file de delta ODP par une logique de checkpoint maison en PySpark. Les consultants capables de trancher, de l'étayer par un pipeline MERGE idempotent et d'épingler leurs dépendances contre les montées de version de HANA Cloud et du runtime Data Flow se positionnent sur l'intersection SAP-plus-Python que le marché EMEA paie 900 à 1 400 €/jour. Ce module est la carte de décision de cette intersection, pas une visite de syntaxe.
Ce que vous apprendrez
- Architecturer des pipelines hana-ml maintenant le calcul dans le moteur HANA — concevoir des chaînes de transformation DataFrame qui diffèrent `.collect()` à l'étape finale, et stocker les artefacts de modèles PAL dans HANA plutôt que dans l'état Python local
- Construire des scripts de chargement de données hdbcli idempotents utilisant des instructions MERGE et des patterns batch executemany, avec une gestion correcte du cycle de vie des connexions pour les environnements HANA Cloud Multi-Tenant
- Connecter un notebook externe (BAS ou Jupyter local) à Datasphere via un utilisateur de base de données Open SQL Schema pour le profilage en push-down et l'inférence ML en base, et placer le Python planifié ligne à ligne dans l'opérateur de script du Data Flow — sans exporter de données hors du tissu gouverné
- Distinguer le rôle approprié de Python dans l'orchestration BDC/Databricks des mécaniques d'extraction ABAP ODP, en prévenant le double traitement en évitant la logique delta redondante dans le code de transformation PySpark
Le vrai rôle de Python dans les pipelines de données SAP
Python est entré dans l'écosystème SAP Analytics par trois portes distinctes, et les confondre conduit à des erreurs architecturales. La première porte est hana-ml, le client Python officiel de SAP pour la HANA Predictive Analysis Library (PAL) et les fonctions de machine learning HANA — il expose les algorithmes PAL (K-Means, Random Forest, décomposition de séries temporelles) comme des objets Python qui poussent le calcul dans le moteur HANA, laissant les données d'entraînement en base. La deuxième porte est hdbcli, le driver Python de bas niveau DB-API 2.0 pour HANA, adapté aux scripts de chargement de données, aux migrations DDL et aux outils opérationnels légers. La troisième porte est un notebook connecté à Datasphere depuis l'extérieur du tenant — Jupyter dans SAP Business Application Studio ou sur votre machine, qui atteint l'Espace via un utilisateur de base de données Open SQL Schema avec hana_ml. Datasphere n'embarque aucun notebook ; le seul Python qui s'exécute à l'intérieur est l'opérateur de script Python d'un Data Flow, une étape pandas planifiée, pas un environnement interactif.
Prérequis
- Expérience pratique intermédiaire sur des projets d'analytique SAP
- Revoir d'abord les concepts fondamentaux : C087, C083, C047
Acquis
- Travailler un scénario réaliste : Un fabricant industriel européen migre le reporting ventes BW/4HANA vers Datasphere et SAP Business Data Cloud.
- Repérer et éviter l'anti-pattern : Matérialiser une table HANA en pandas avant filtrage — Déplace le calcul du moteur HANA vers l'hôte Python.
- Appliquer la décision clé du module : DataFrame hana-ml vs hdbcli pour une tâche de pipeline donnée — choisir hana-ml pour l'analytique en pushdown et l'entraînement de modèle PAL.
- Mesurer la maîtrise avec le KPI : Ratio de push-down (cible : >= 90 % des étapes de pipeline s'exécutent dans HANA avant le premier .collect).
Module complet réservé aux abonnés. Le module complet ajoute : le cadre de décision · le cas guidé de bout en bout · la grille de KPI · les anti-patterns · les blocs de code · le contrôle de connaissances · les schémas.