Flux de données et transformations
À jour au 2026-10-04
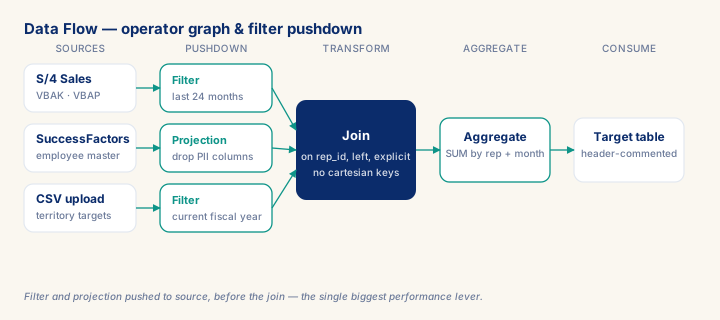
Data Flow = surface ETL pour ce que Replication Flow ne peut pas (joins cross-sources, ingest fichier, dérivations complexes, SCD Type 2). Règle senior : préférer Replication Flow; Data Flow seulement quand la transformation est nécessaire. Maîtriser 7 opérateurs (Source/Target/Join/Projection/Aggregation/Lookup/Filter + Script). Pousser filtres et projections vers la source. Commentaire d'en-tête sur chaque flow = protection héritage.
Ce que vous apprendrez
- Travailler un scénario réaliste : SaaS B2B, le reporting de performance des commerciaux nécessite S/4 (commandes) + SuccessFactors (détails commerciaux) + CSV mensuel (objectifs de territoire).
- Repérer et éviter l'anti-pattern : Data Flow utilisé pour du CDC mono-source — Coût plus élevé, latence plus élevée qu'un Replication Flow.
- Appliquer la décision clé du module : Data Flow vs Replication Flow — choisir Replication pour CDC d'une source SAP unique ; Data Flow quand 2+ sources ou transformation nécessaire.
- Mesurer la maîtrise avec le KPI : Temps d'exécution P95 (cible : < fenêtre planifiée ; signal d'alerte : > fenêtre = pushdown manqué ou sous-dimensionnement CU).
Aperçu du module
Data Flow est la surface ETL de Datasphere — pour les transformations que Replication Flow ne sait pas faire (jointures cross-sources, logique métier complexe, ingestion CSV/fichier externe, lookups, dérivations). Règle senior : préférer Replication Flow quand possible; ne dégainer Data Flow que quand la transformation est vraiment nécessaire.
Quand Data Flow gagne.
- Sources multiples (S/4 + SuccessFactors + Salesforce) joints en un fait.
- Sources fichier (uploads CSV, Excel mensuels).
- Dérivations métier complexes (allocation de revenu, conversion devise à taux custom, dérivation fiscale).
- Dimensions à variation lente (suivi historique Type 2).
- Pré-agrégation quand la donnée brute est trop volumineuse ou trop sensible à exposer.
Quand Data Flow perd.
- CDC depuis une source SAP unique → utiliser Replication Flow (moins cher, natif).
- Latence temps-réel / sous-minute → Data Flow tourne en batch; plancher de latence ~minutes.
- Transformation qui devrait logiquement vivre dans la couche modèle analytique → la mettre dans une vue, pas un Data Flow.
Prérequis
- Revoir d'abord les concepts fondamentaux : C008, C006, C005
Acquis
- Travailler un scénario réaliste : SaaS B2B, le reporting de performance des commerciaux nécessite S/4 (commandes) + SuccessFactors (détails commerciaux) + CSV mensuel (objectifs de territoire).
- Repérer et éviter l'anti-pattern : Data Flow utilisé pour du CDC mono-source — Coût plus élevé, latence plus élevée qu'un Replication Flow.
- Appliquer la décision clé du module : Data Flow vs Replication Flow — choisir Replication pour CDC d'une source SAP unique ; Data Flow quand 2+ sources ou transformation nécessaire.
- Mesurer la maîtrise avec le KPI : Temps d'exécution P95 (cible : < fenêtre planifiée ; signal d'alerte : > fenêtre = pushdown manqué ou sous-dimensionnement CU).
Module complet réservé aux abonnés. Le module complet ajoute : le cadre de décision · le cas guidé de bout en bout · la grille de KPI · les anti-patterns · les blocs de code · le contrôle de connaissances · les schémas.