Gestion des incidents et problèmes
À jour au 2026-10-06
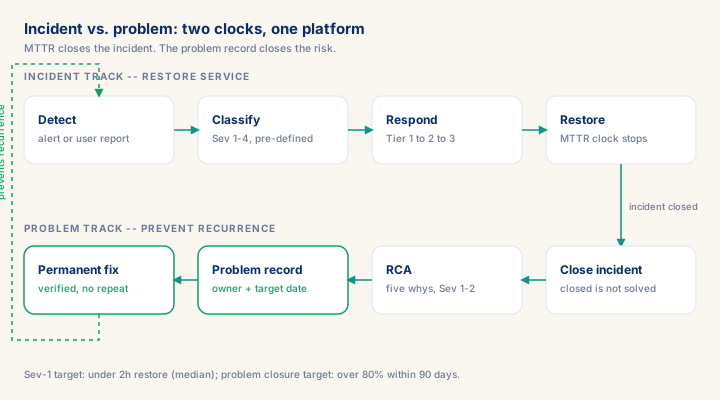
Une interruption de plateforme analytique n'est pas le moment d'investiguer la cause racine — c'est le moment de restaurer le service par la voie la plus rapide et sûre, en s'appuyant sur la distinction fondamentale ITIL entre gestion des incidents (restaurer le service, piloté par le MTTR) et gestion des problèmes (correctif permanent, empêche la récidive). Ce module définit un modèle de sévérité à quatre niveaux pour les incidents Datasphere/SAC/BW, une conception d'astreinte en couches (Niveau 1 premier intervenant jusqu'au Niveau 3 support SAP), le contenu de runbook que toute équipe de plateforme doit maintenir (runbooks nommés pour les échecs de flux de données, l'OOM HANA, les échecs de chargement SAC, les échecs de chaîne de processus BW/4HANA), la méthode des cinq pourquoi appliquée à une chaîne d'incidents réelle, et les métriques MTTR/clôture des problèmes/taux d'incidents répétés qui distinguent une exploitation mature de la simple gestion de crise. L'apprenant repart avec une matrice de sévérité, une conception d'astreinte et un template de gouvernance des enregistrements de problèmes.
Ce que vous apprendrez
- Travailler un scénario réaliste : Un groupe de retail européen exploitant Datasphere.
- Repérer et éviter l'anti-pattern : Redémarrer HANA Cloud comme première réponse à un OOM.
- Appliquer la décision clé du module : Où tracer la ligne Sev-1 — choisir Réserver Sev-1 pour une indisponibilité totale ou une défaillance à point unique touchant tous les utilisateurs.
- Mesurer la maîtrise avec le KPI : MTTR Sévérité-1 (médian) (cible : Sous 2 heures ; signal d'alerte : Le médian s'améliore pendant que le MTTR P90 du même palier s'aggrave -- le mix d'incidents est manipulé).
Gestion des incidents et des problèmes pour les plateformes SAP Analytics
La distinction entre rétablir le service et empêcher la récidive est le principe central de la gestion des incidents et des problèmes selon ITIL — et elle est fréquemment brouillée dans l'exploitation des plateformes analytiques, avec des conséquences coûteuses. Une panne de plateforme analytique à 07h30 un lundi matin, alors que les tableaux de bord de reporting du directeur financier sont noirs, n'est pas le moment d'investiguer les causes racines. C'est le moment de rétablir le service par le chemin sûr le plus rapide. L'investigation vient plus tard, dans un enregistrement de problème structuré, et produit un correctif permanent qui empêche la classe d'incident de se reproduire.
Prérequis
- Expérience pratique intermédiaire sur des projets d'analytique SAP
- Revoir d'abord les concepts fondamentaux : C038, C041, C040
Acquis
- Travailler un scénario réaliste : Un groupe de retail européen exploitant Datasphere.
- Repérer et éviter l'anti-pattern : Redémarrer HANA Cloud comme première réponse à un OOM.
- Appliquer la décision clé du module : Où tracer la ligne Sev-1 — choisir Réserver Sev-1 pour une indisponibilité totale ou une défaillance à point unique touchant tous les utilisateurs.
- Mesurer la maîtrise avec le KPI : MTTR Sévérité-1 (médian) (cible : Sous 2 heures ; signal d'alerte : Le médian s'améliore pendant que le MTTR P90 du même palier s'aggrave -- le mix d'incidents est manipulé).
Module complet réservé aux abonnés. Le module complet ajoute : le cadre de décision · le cas guidé de bout en bout · la grille de KPI · les anti-patterns · les blocs de code · le contrôle de connaissances · les schémas.